
Il nostro è un mestiere affascinante, complesso e legato all’incertezza. Stiamo parlando di chi operi sui mercati finanziari, a prescindere dalle tecniche che utilizzi, siano esse legate ad un approccio discrezionale, sistematico o aiutato dalle nuove tecnologie AI. E al di là delle suggestioni che alcuni di questi approcci possono avere sulla nostra percezione, sono sempre e solo i risultati di medio e lungo termine a decretare la bontà di tali metodologie. L’osservazione di medio e lungo termine deve servire, a seconda della tecnica utilizzata, a discriminare risultati “fortunati”, legati magari ad una singola buona intuizione iniziale non riproducibile (si pensi all’acquisto di asset e alla loro tenuta in portafoglio per anni, tecnica di buy&hold). Un esempio concreto sono coloro che hanno acquistato titoli azioni durante fasi espansive come quella della new economy a fine secolo scorso o post crisi subprime, chi ha tenuto per un decennio penny stock che sono esplose o cryptocurrency negli ultimi dieci anni. Lungi da noi voler togliere merito a tali investimenti (i risultati parlano per loro), qui non stiamo cercando di indagare poche occorrenze “andate bene”, ma una progressione statisticamente osservabile di azioni ripetitive che costituiscano un metodo.
Ma quindi cosa stiamo cercando di indagare esattamente?
Vogliamo comprendere se e come sia possibile generare valore nel tempo, sui mercati finanziari, individuando e sfruttando ripetitività statisticamente rilevabili, mischiando l’approccio sistematico con quello AI driven. In parole semplici vogliamo capire se esista un vantaggio competitivo intrinsecamente legato ai dati finanziari.
E’ inutile girarci intorno. Chi come noi lavora da anni sul machine learning con grandi moli di dati finanziari, si misura quotidianamente sulla capacità di tali dati di prevedere il futuro. E tale capacità, nel 2024, deve essere commisurata a quella di un operatore che prenda decisioni di tipo discrezionale. I più attenti qui potrebbero obiettare che l’operatore discrezionale potrebbe prendere le proprie decisioni operative, non solo sulla base dei dati osservati, ma anche del contesto e della propria esperienza sul campo, facendo riferimento, cioè, a dati apparentemente slegati dal problema in esame. Potrebbe cambiare comportamento in base alla stagione, allo stato psicofisico, a delle imminenti elezioni (vedi quelle USA della prossima settimana) o a qualsiasi altro “elemento di disturbo”. Ma tutti questi elementi, nella loro complessità, caratterizzano dei dati che possono essere utilizzati, o meno, anche da un modello di apprendimento automatico (fatta eccezione, in parte, per lo stato psico-fisico).
Ma è davvero possibile sintetizzare tutti questi dati e di che incertezza parliamo?
Per sgomberare il campo agli equivoci dirò subito che siamo ben lontani da una previsione perfetta, parliamo piuttosto di “previsione statistica”. Ma portarsi dalla propria parte anche solo qualche punto percentuale di probabilità, può fare un’enorme differenza e, chi opera sui mercati finanziari, questo lo sa bene. Lo sanno bene i moderni hedge fund, che investono capitali sempre più importanti sulle nuove tecnologie.
Ma di che tipo di previsioni stiamo parlando?
Tutti vengono proiettati immediatamente verso la previsione diretta dei prezzi (o comunque della loro variazione percentuale), e va detto che esistono dei risultati molto interessanti da questo punto di vista (ne parleremo in un secondo articolo). Ma spesso quello che è possibile fare è più sottile, ma non meno utile. Una di queste applicazioni del machine learning (su cui stiamo lavorando da anni) è la clusterizzazione delle dinamiche di volatilità.
Immaginate di essere un trader in opzioni e di avere una previsione settimanale o giornaliera della volatilità attesa sui propri strumenti di lavoro. Questo aggiungerebbe una terza chiave alla volatilità storica e alla volatilità implicita, con i conseguenti vantaggi misurabili all’interno di una strategia (futuri articoli tratteranno anche questo tema). Oppure immaginate di essere un progettista di trading system e di voler utilizzare tale informazione per filtrare i segnali generati dalle proprie macchine. Questo costituirebbe davvero un grosso vantaggio competitivo.
Ora esistono tre elementi da considerare quando si progettano sistemi previsionali: i dati, i modelli di machine learning utilizzati ed il tempo. Queste grandezze sono legate da relazioni spesso decisive ai fini del risultato finale.
I dati
Si tratta della banca dati, opportunamente trattata, che costituisce l’input dei nostri sistemi. Facendo riferimento ai mercati regolamentati, può contenere dati di prezzo, di volume, macroeconomici (come i tassi di interesse o il tasso di disoccupazione), dati alternativi legati ai transiti autostradali, alle fasi lunari, alle tempeste solari, ai disastri naturali o alle curve di sentiment dei principali opinion leader e molto altro ancora (qui solo la ricerca sulla loro reale efficacia può guidare sul loro utilizzo). Quella dei dati caratterizza la variabile più importante e decisiva per il buon esito del nostro esperimento. Se i dati non contengono elementi predittivi della voce che vogliamo prevedere, al loro interno, l’intera indagine fallirà, presentando risultati assimilabili a scelte dettate dal caso.
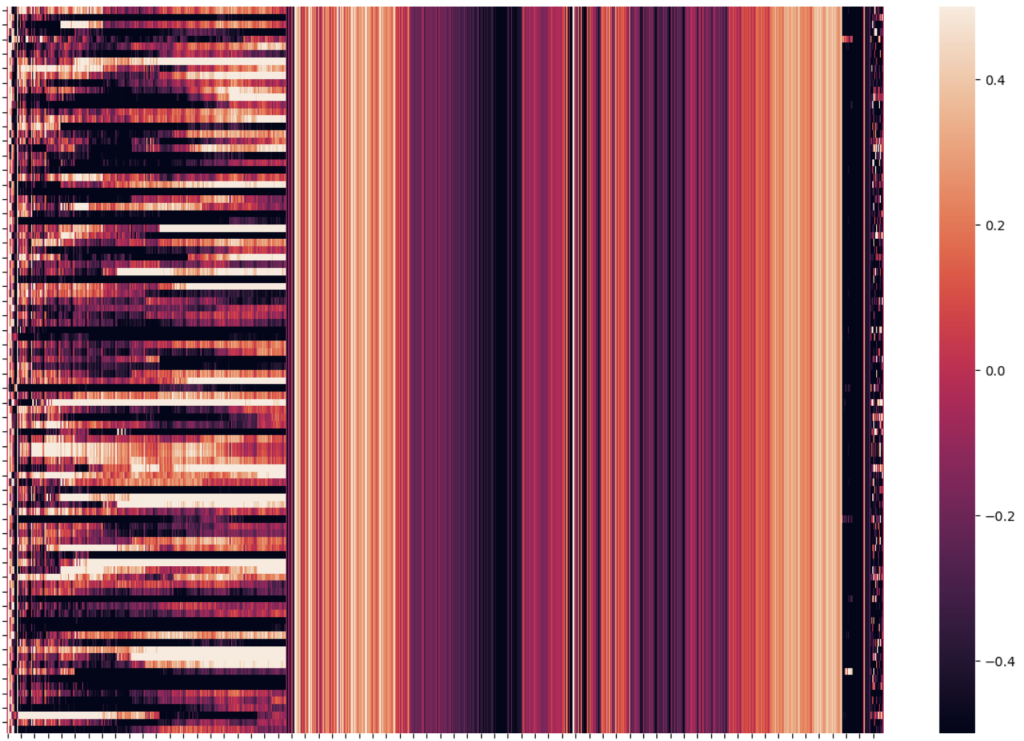
In figura si può osservare il campionamento temporale di un dataset opportunamente lavorato, con dati legati ad un basket azionario (sulla sinistra) e dati di “contesto” (a destra) per guidare una scelta generale.
I modelli
I modelli di machine learning possono avere caratteristiche molto diverse, utilizzare funzioni lineari o non lineari a complessità crescente e questo va commisurato al problema che dobbiamo risolvere. Si passa dalla Regressione Lineare, la Regressione Logistica, i Decision Tree, il Random Forest, le Support Vector Machine, i metodi ensemble (XGBoost, LightGBM, CatBoost) fino alle Stacked Deep Neural Network (MLP, CNN, LSTM ecc.) In generale l’importanza del modello, una volta associata correttamente la corretta categoria alla variabile da prevedere, è inferiore rispetto alla qualità dei dati utilizzati.
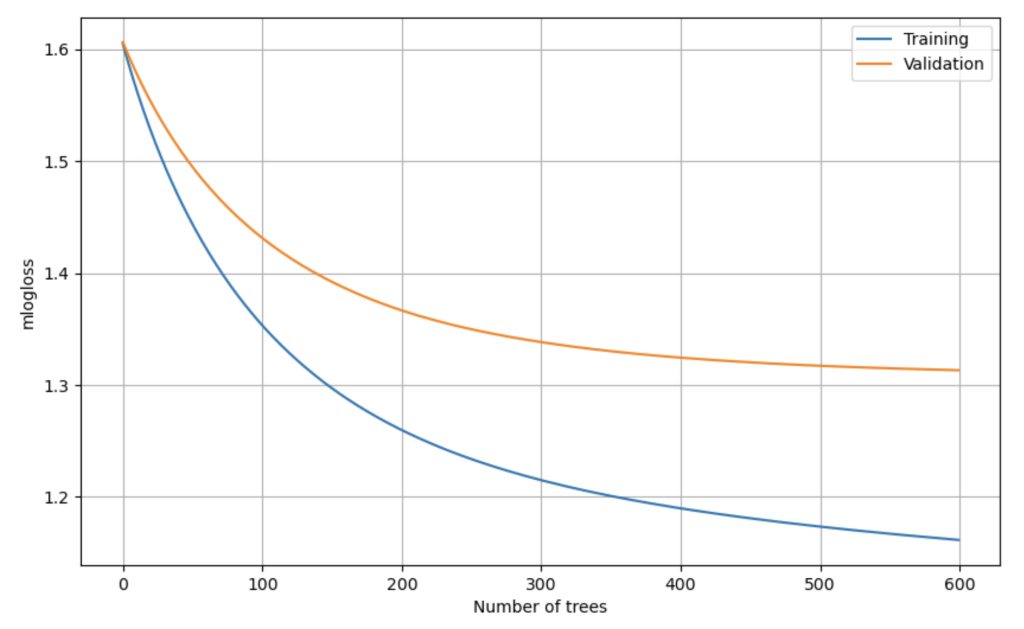
In figura possiamo apprezzare la curva di apprendimento di un algoritmo ensemble (ad alberi decisionali) su dati di addestramento (in sample, in blu) e su dati sconosciuti (out of sample, in arancione). Quello che emerge è una buona capacità di migliorare le proprie decisioni in rapporto ai dati di input. Si tratta del primo elemento da considerare per poter procedere con l’utilizzo di un modello, prima ancora di giudicare i risultati sul campo.
Il tempo
E’ il fattore più limitante. Stiamo parlando del tempo di elaborazione e di addestramento, ma anche di quello di esecuzione. Più diventa “massivo” un dataset, più ci si sposta da un problema classico di machine learning ad uno di big data analysis e questo non può che avere forti implicazioni sulle risorse a disposizione. Se è vero che la tecnologia (e qui parliamo in particolare di hardware) viene in nostro soccorso, è anche vero che le moderne tecniche di “dimensionality reduction” e di “feature selection” permettono di ridurre notevolmente i tempi di elaborazione.
Prevedere la Volatilità
In questo articolo desideriamo presentare una delle applicazioni cui stiamo lavorando da anni e che caratterizza uno dei predittori più efficaci che è possibile sintetizzare addestrando opportunamente ed in modo dinamico, il nostro modello di machine learning proprietario: la previsione a cluster di volatilità.
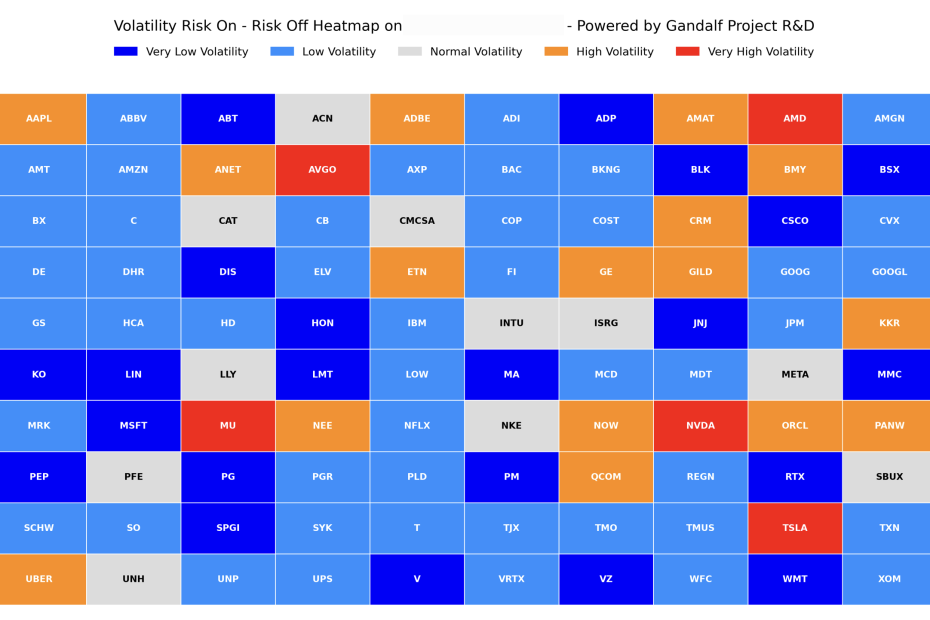
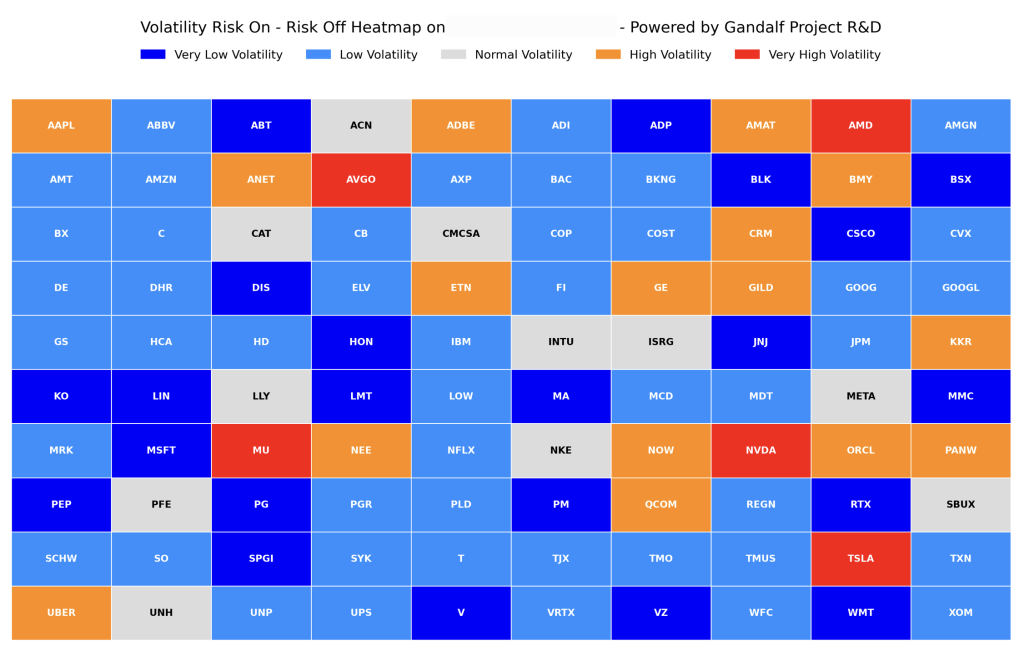
Nell’esempio di seguito potete osservare una heatmap che presenta i cinque cluster di volatilità sui primi 100 titoli dell’S&P500 per capitalizzazione, per una specifica data:
Blu scuro: previsto un forte decremento di volatilità.
Blu chiaro: previsto un sensibile decremento di volatilità.
Grigio ghiaccio: prevista volatilità sostanzialmente inalterata intorno alla media.
Arancione: previsto sensibile aumento di volatilità.
Rosso: previsto un forte aumento di volatilità.
Gli stessi output possono ovviamente essere presentati con una maggiore profondità di dettaglio: associando, ad esempio, la probabilità a ciascuna classe (immaginate le implicazioni sulle size da utilizzare in un sistema composito di asset allocation per minimizzare il rischio atteso).
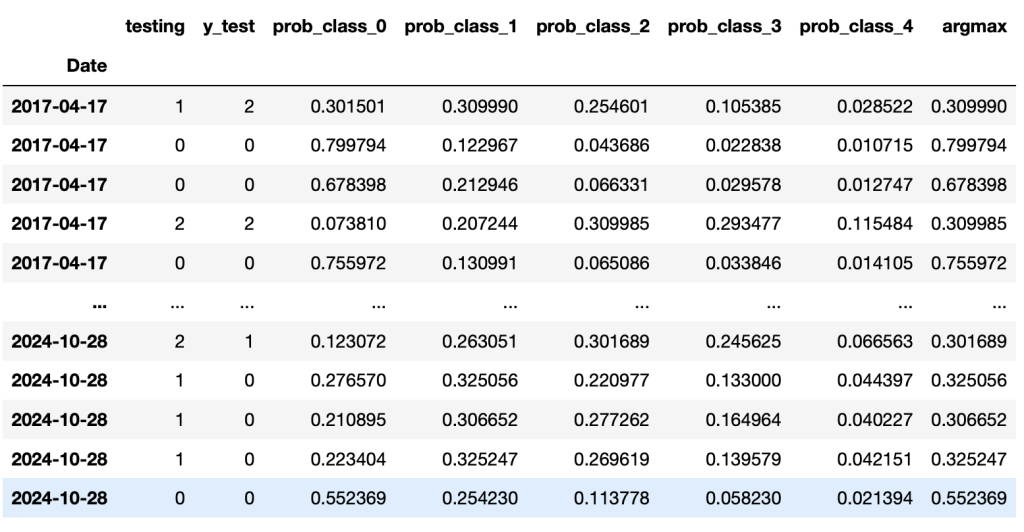
La tabella qui sopra associa la probabilità con cui la macchina si pronuncia su ciascuna classe: nell’ultima riga (corrispondente ad uno specifico asset), ad esempio, la classe 0, quella con la maggior confidenza, è riconosciuta con il 55% di probabilità.
Ma ci serve un modo quantitativo per riconoscere senza ambiguità la bontà o meno della nostra predizione.
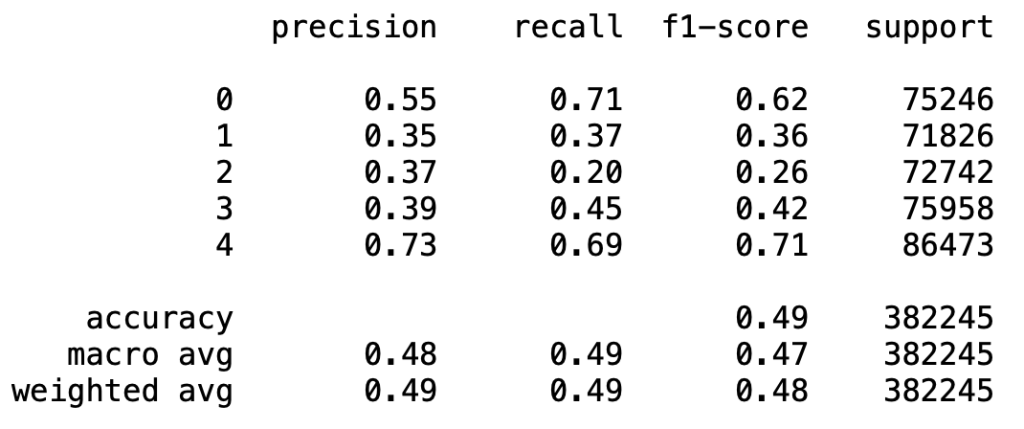
Di seguito un Classification Report (preso da una delle prove intermedie di sviluppo e che verrà successivamente migliorato e reso omogeneo tra le classi) che associa una determinata Accuracy (Accuratezza) a ciascuna classe:
Valutazione per Classe:
Classe 0 ha una performance discreta, con una precisione di 0.55 (55%) e un recall di 0.71, risultando in un F1-score di 0.62. Questo indica che il modello è ragionevolmente efficace nell’identificare i campioni di questa classe.
Classe 4 mostra anch’essa buone prestazioni, con una precisione di 0.73 (73%), recall di 0.69 e un F1-score di 0.71, suggerendo che il modello prevede accuratamente questa classe.
Classi 1, 2 e 3 mostrano precisioni, recall e F1-score più bassi, con la Classe 2 particolarmente problematica (F1-score di 0.26). Questo suggerisce che il modello fatica a distinguere correttamente i campioni di queste classi, probabilmente a causa di caratteristiche sovrapposte o della difficoltà di separazione tra di esse.
Valutazione Generale:
Accuratezza: L’accuratezza complessiva è di 0.49, il che indica che il modello prevede correttamente circa il 49% dei campioni.
Media Macro: L’F1-score macro medio è 0.47.
Media Ponderata: L’F1-score ponderato è 0.48, tenendo conto del supporto di ciascuna classe. Questo valore, leggermente superiore alla media macro, indica che il modello performa meglio sulle classi più frequenti, ma ha difficoltà con quelle meno comuni.
Per determinare se questi risultati siano migliori di una classificazione casuale, esaminiamo le performance del modello rispetto a ciò che ci aspetteremmo dal caso.
Base di Riferimento Casuale:
In un problema di classificazione con 5 classi, un classificatore totalmente casuale avrebbe un’accuratezza di circa il 20% (1 su 5).
Precisione, recall e F1-score sarebbero approssimativamente 0.20 per ogni classe se le previsioni fossero casuali e uniformemente bilanciate.
Risultati Osservati:
L’accuratezza complessiva del modello è di 0.49, più del doppio rispetto alla base casuale di 0.20. Questo suggerisce che il modello sta effettivamente catturando alcune informazioni significative nei dati, piuttosto che fare solo delle scelte casuali.
Le Classi 0 e 4 mostrano precisione, richiamo e F1-score significativamente superiori a quelli attesi per una classificazione casuale (con la Classe 4 che ha il miglior F1-score di 0.71). Questo indica che il modello riesce a distinguere queste classi in modo abbastanza accurato.
Classi 1, 2 e 3 mostrano performance più basse, con F1-score tra 0.26 e 0.42. Sebbene questi punteggi non siano ideali, sono comunque superiori a 0.20 (il livello atteso per il caso), il che suggerisce che il modello performa meglio di una classificazione casuale anche per queste classi più difficili da distinguere. Le difficoltà del modello con queste classi potrebbero essere dovute a una sovrapposizione delle caratteristiche, a uno sbilanciamento delle classi o alla mancanza di caratteristiche abbastanza distintive. Tuttavia, il modello riesce comunque a catturare una certa struttura nei dati.
E’ su questa base che si procede, per tentativi ed errori, fino alla corretta presentazione dei dati realmente utili alla causa.
Ma qual è la ricaduta di una accuracy media del 49% a livello operativo?
In uno dei prossimi articoli vedremo queste previsioni in azione per declinare il rischio di asset allocation e per filtrare strategie di trading e investing quantitative.
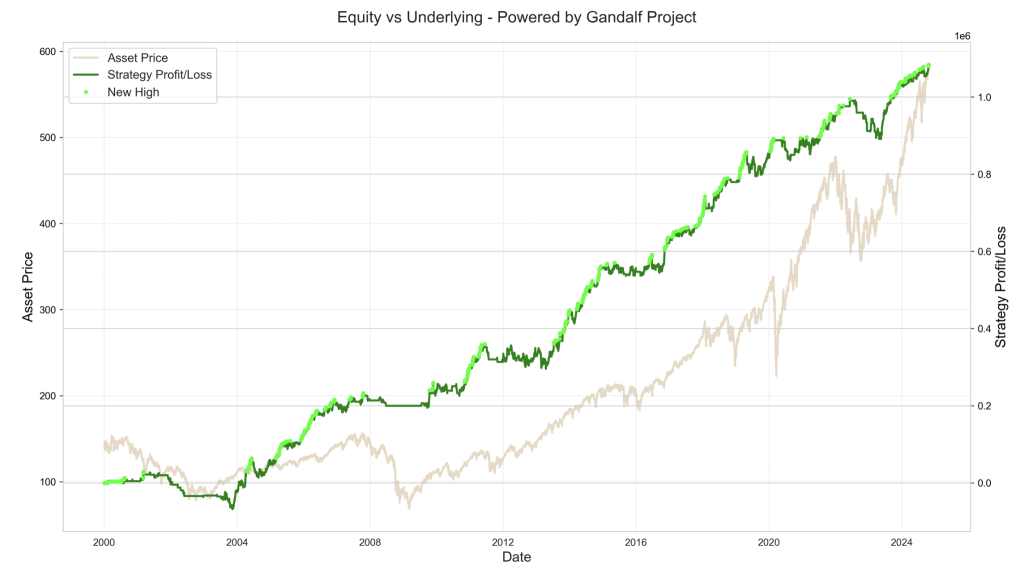
Tutte le tavole e le elaborazioni presentate in questo articolo sono state ottenute con codice Python. Le competenze richieste vengono approfondite all’interno dei due acceleratori didattici di Gandalf Project: Python Academy e Machine Learning Academy.
Chi fosse interessato ad approfondire questi temi o a ricevere informazioni relative ai servizi di forecasting disponibili (prezzo, volatilità e scenari di mercato), può scriverci ad info@gandalfproject.com.
Giovanni Trombetta
Founder – Head of R&D
Gandalf Project
